Tablas de caché de 1,4 TiB que bloqueaban los deploys
Un deploy a staging falló tres veces seguidas. La culpa era de una base de datos de 1,4 TiB que casi entera era caché de Drupal.
- #drupal
- #mysql
- #devops
- #cache
Hace poco me tocó hacer un deploy a staging que, en teoría, iba a ser rutinario. Era un sitio Drupal grande, con un pipeline que ya funcionaba bien. Aun así, falló tres veces seguidas, y cada vez por una razón distinta.
Para quien no trabaja en esto: un deploy es el proceso de llevar una nueva versión del sitio a un servidor, y staging es el entorno de pruebas donde revisamos todo antes de que llegue a producción, que es el sitio real que usa la gente.
Tres errores, uno detrás de otro #
La primera vez, el código se actualizó bien, pero drush updatedb (la herramienta que aplica los cambios pendientes a la base de datos) no lograba arrancar Drupal. Lo ejecuté con más detalle (-vvv) y apareció esto:
[info] key_value table not found. Database may be empty.La base de staging tenía 93 tablas, en orden alfabético, y se cortaba más o menos en cache_dynamic_page_cache. Es decir, una copia desde producción se había quedado a medias.
La segunda vez le pedí al pipeline que copiara la base de producción, y el servidor de integración continua (CI) se quedó sin memoria al descargar el respaldo. El respaldo pesaba unos 55 GB comprimido, mucho más de lo que esperaba.
La tercera vez no copié nada. Las actualizaciones corrieron bien, pero al llegar a la limpieza de caché apareció otro error:
SQLSTATE[70100]: 1317 Query execution was interrupted:
TRUNCATE "cache_dynamic_page_cache"
En ese momento entendí que el problema no estaba en el pipeline, y me puse a revisar la base de datos.
La base era casi toda caché #
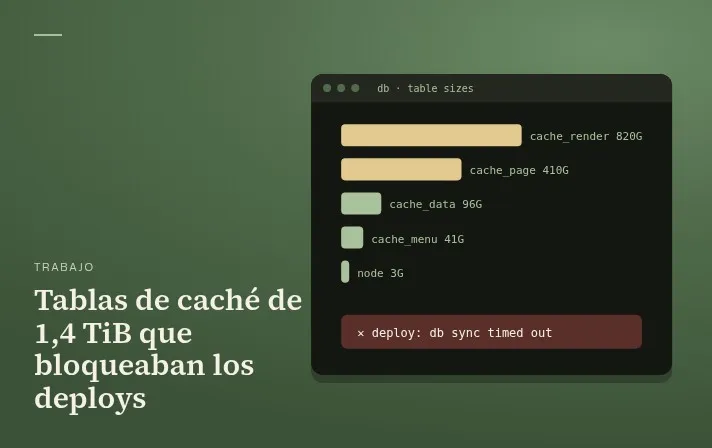
Los registros del respaldo nocturno mostraban cuánto pesaba cada tabla. La base de producción tenía 1,4 TiB, y casi todo ese espacio lo ocupaban cuatro tablas: cache_page, cache_dynamic_page_cache, cache_render y cache_data. Solo las dos primeras pasaban de 1 TiB. Me sorprende mucho que una caché llegue a ese tamaño sin que nadie lo note.
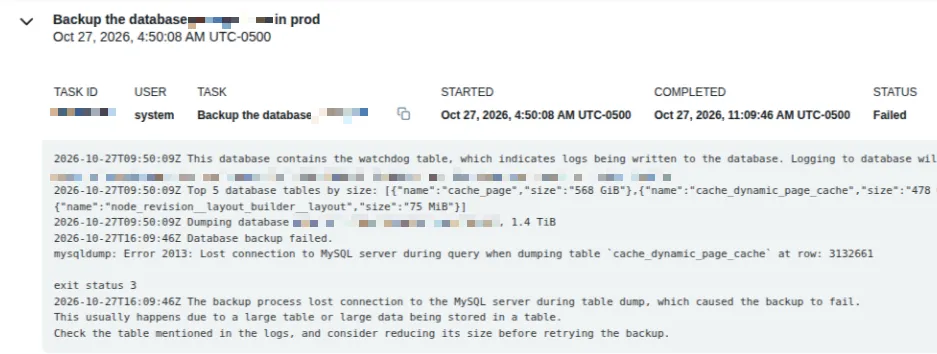
El respaldo nocturno de producción fallaba con una base de 1,4 TiB. Los datos internos están pixelados.
La caché, en pocas palabras, es una copia guardada de páginas o datos para no tener que calcularlos cada vez. Es útil, pero es temporal: se puede borrar y volver a generar en cualquier momento, y no debería crecer sin control.
Con eso, todo empezó a tener sentido. La copia a staging no estaba colgada; simplemente tardaba horas, y el deploy ejecutó updatedb contra una base importada a medias. El servidor de CI no tenía espacio para 55 GB. Y el TRUNCATE (el comando que vacía una tabla) estaba esperando un bloqueo: el respaldo nocturno tenía un mysqldump leyendo cache_dynamic_page_cache desde hacía más de 4 horas, y TRUNCATE necesita acceso exclusivo a la tabla. Por eso se quedó esperando, hasta que yo mismo detuve todo lo que seguía corriendo.
¿Por qué crecía sin parar? #
Esta fue la parte que más disfruté investigar. Con la caché guardada en la base de datos, Drupal debería mantener cada grupo de caché (lo que llama bin) en unas 5.000 filas. Cada vez que corre el cron, que es la tarea programada de mantenimiento, system_cron() llama a garbageCollection() en todos los bins y borra lo que sobra.
En producción el cron estaba corriendo con normalidad, pero cache_page tenía más de 4 millones de filas. La lista de procesos de la base de datos se veía más o menos así:
SELECT /*!40001 SQL_NO_CACHE */ * FROM cache_dynamic_page_cache   -- 6 horas
DELETE FROM cache_dynamic_page_cache WHERE created <= ...         -- esperando
INSERT INTO cache_render ...                                      -- en cola
El DELETE de la limpieza trabajaba sobre cientos de GB y nunca terminaba, porque lo cortaba un límite de tiempo o el respaldo nocturno. Y lo más delicado: el cron captura el error y registra igual que terminó (system.cron_last), así que todo parecía estar bien mientras las tablas seguían creciendo. Además, había bastante tráfico de bots generando nuevas entradas de caché más rápido de lo que el cron alcanzaba a limpiarlas. Era una bola de nieve.
Cómo lo resolví #
En staging esperé a que terminara la copia, hasta que drush status mostró Bootstrap Successful. Después detuve el mysqldump que tenía bloqueada la tabla y vacié todas las tablas cache*:
SHOW FULL PROCESSLIST;
KILL <id_del_dump>;
TRUNCATE cache_page;
-- ...y el resto de cache_*
Pasó algo curioso: después del primer intento, cache_page y cache_dynamic_page_cache seguían llenas. Creo que la transacción del respaldo todavía no las liberaba, pero sinceramente no estoy seguro. Lo ejecuté otra vez en esas dos y funcionó. Un consejo: verifica con SELECT COUNT(*) y no con lo que dice information_schema, porque esas estadísticas se guardan en caché y me seguían mostrando cientos de GB después de vaciar las tablas.
Con eso, el deploy por fin pasó en verde.
En producción hice lo mismo, pero primero lo coordiné con el equipo. Detuve el respaldo nocturno, que se había quedado trabado, y los dos DELETE de la limpieza, que se revierten al detenerse, aunque el TRUNCATE vacía las tablas de todas formas. Después ejecuté drush cr, que con este tipo de caché termina vaciando cada bin. Poco después, las cuatro tablas tenían apenas unos cientos de filas, todas de tráfico nuevo.
Y hubo un beneficio extra. Los entornos de vista previa los manejamos con Tugboat, una herramienta que crea una copia del sitio para revisar cada cambio. Para armar esa copia, Tugboat descarga el respaldo más reciente de la base de producción. Con tanta caché, la cuenta de Tugboat llegó a su cuota: la vista previa principal se quedó congelada en “Building” ocupando 522 GB, y el respaldo nocturno de 55 GB comprimido era más de lo que Tugboat podía manejar.
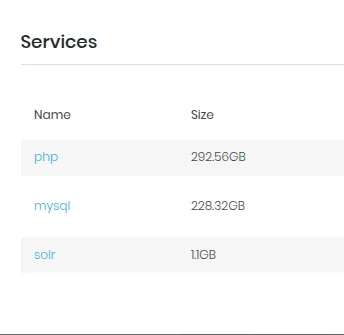
La vista previa principal antes del arreglo.
Por eso no bastaba con limpiar la caché: también hacía falta un respaldo nuevo, porque Tugboat siempre usa el más reciente. Después de vaciar las tablas en producción, saqué un respaldo nuevo y reconstruí la vista previa.
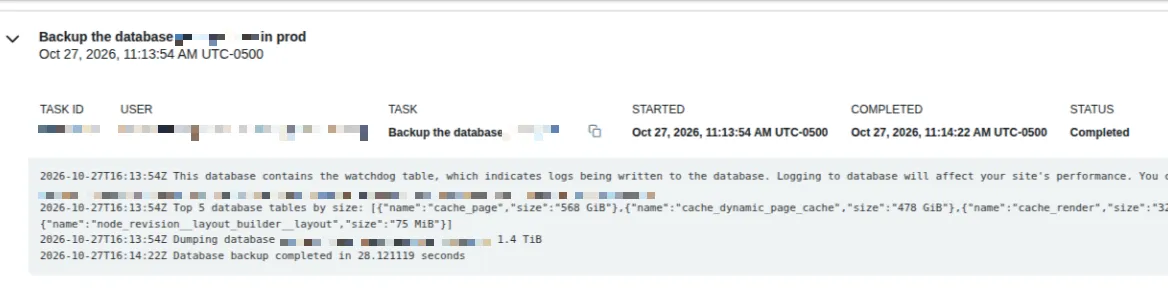
El respaldo nuevo, ya sin la caché acumulada. Los datos internos están pixelados.
Ahora la vista previa ocupa unos 7,2 GB y se levanta en unos 10 minutos.
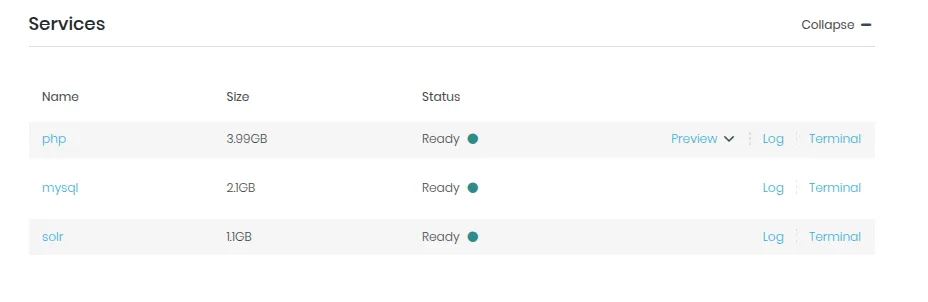
La misma vista previa después del arreglo.
Lo que me llevo #
Si un pipeline falla de tres formas distintas, conviene mirar los datos y no solo el pipeline. Que el cron diga que corrió no significa que terminó su trabajo. TRUNCATE y mysqldump no se llevan bien, así que si tu deploy limpia la caché, es mejor no hacerlo mientras corre el respaldo. Y al importar una base, puedes dejar fuera las filas de caché, por ejemplo así:
gunzip -c db.sql.gz | grep -v '^INSERT INTO `cache_' | drush sql:cliUn detalle más: agrega set -o pipefail a cualquier importación que use pipes. Sin eso, una importación que se cortó a la mitad puede aparecer como exitosa.
Todavía me falta confirmar que la limpieza ya alcanza a mantener las tablas en unas 5.000 filas. Si no es así, el siguiente paso será sacar esos bins de MySQL, pasarlos a Memcached y frenar a los bots. Mientras tanto, toca vigilar que la base de producción no vuelva a crecer sin control. Pero eso ya será tema de otro post.